Локальная нейросеть: дешевле ли она, чем API
Локальная нейросеть выгоднее API при большом постоянном объёме, дорогой облачной модели или закрытых данных, потому что цена видеокарты делится на месяцы службы, а миллион токенов дешёвой облачной модели стоит центы. По расчёту исследователей Pan и соавторов, своё железо оправдано в основном от 50 млн токенов в месяц. Сначала посчитайте свои токены и проверьте, тянет ли модель ваш компьютер.
Роман Кауфман, основатель Кауфман Lab · Данные на: октябрь 2026
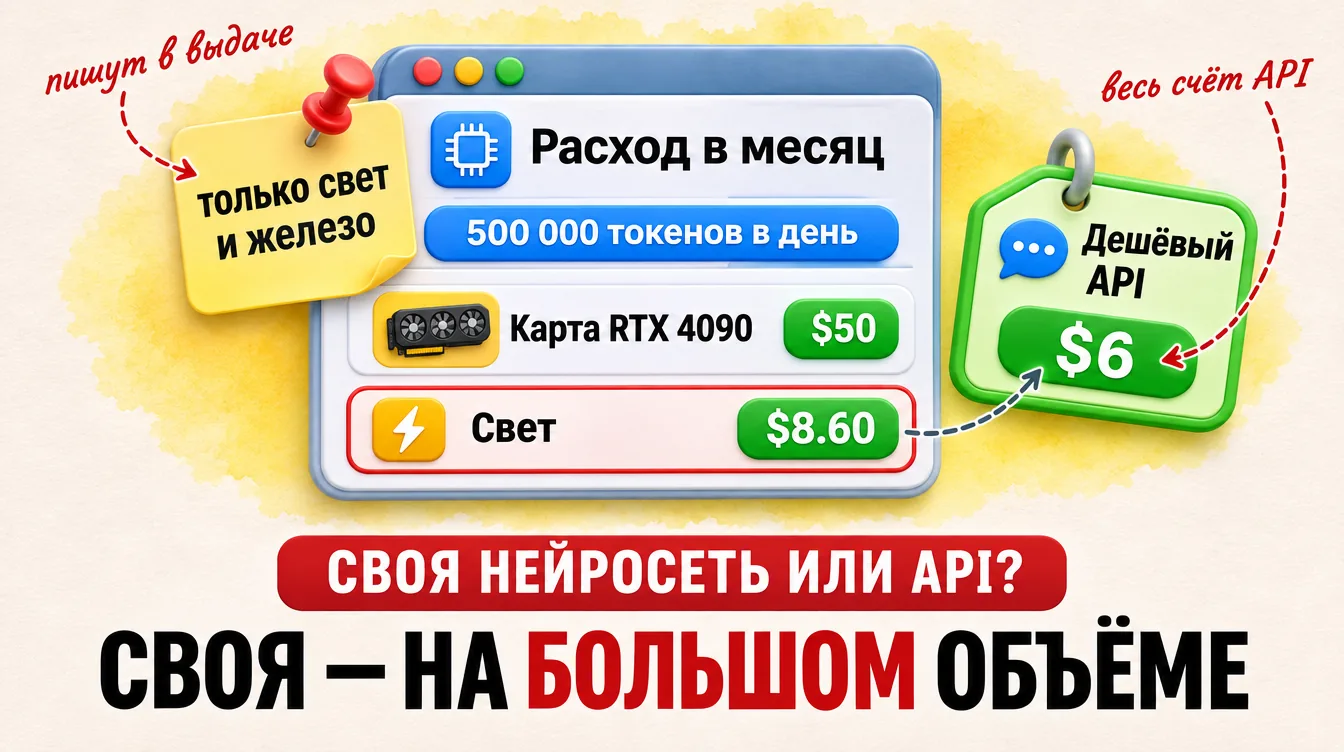
Студенту, который сам делает себе сайт, локальную модель советуют словами «Вы тратитесь только на электричество и железо». Другой путь называют API. Там модель работает в чужом облаке, а вы платите за объём текста.
С августа 2026 года модель нашего личного ИИ-помощника тоже живёт в облаке, ему нужно пять-десять вызовов в сутки. Почему не на своём компьютере, если свет почти ничего не стоит? Ответ в счёте за электричество.
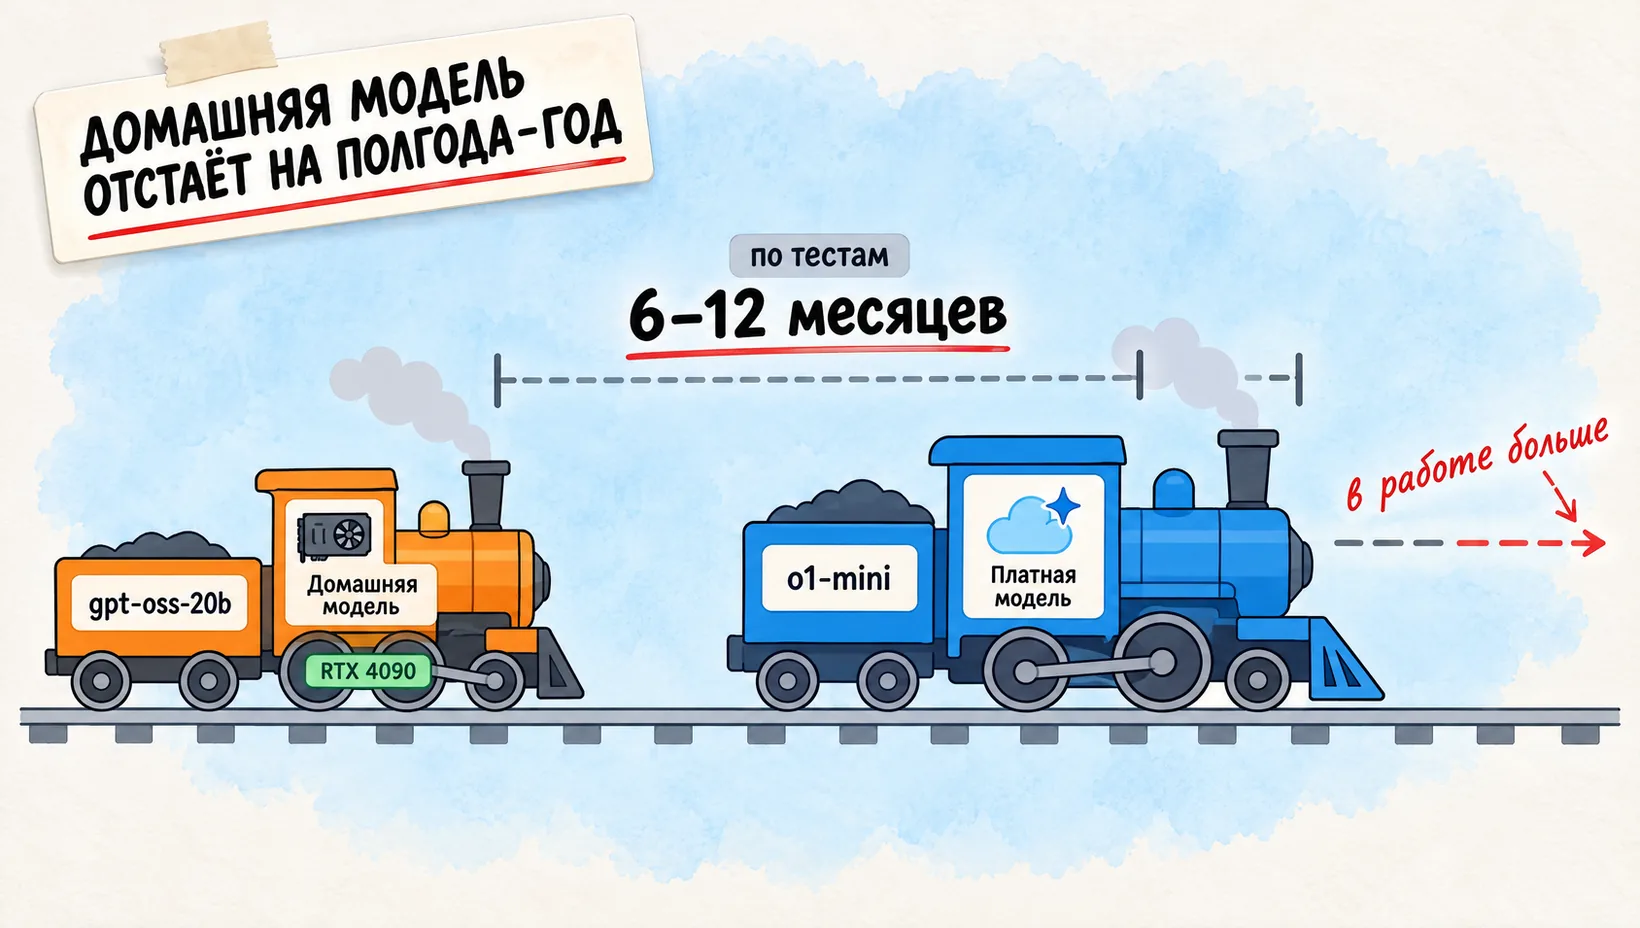
Домашняя модель отстаёт от платных на полгода–год
Модель, которая помещается в одну домашнюю видеокарту, догоняет лучшие платные через 6–12 месяцев. Такой срок получили исследователи Epoch AI Венкат Сомала и Люк Эмберсон в разборе от 9 сентября 2025 года по четырём тестам. Домашней они считают модель до 28 млрд параметров для карты RTX 4090.
Авторы сами предупреждают, что лучшую открытую модель чаще подгоняют под тесты, поэтому в реальной работе отставание, скорее всего, больше. По их грубой оценке, открытая gpt-oss-20b может быть сравнима с платной o1-mini, а разрыв между ними 11 месяцев.
Своё железо окупается против дорогих API или на большом объёме
Своя видеокарта отбивает деньги, если сравнивать её с дорогой облачной моделью или гонять через неё очень много текста. Расчёт окупаемости своего железа исследователи Guanzhong Pan и соавторы выложили 11 ноября 2025 года. Порог у них в основном от 50 млн токенов в месяц (токеном называют кусочек текста).
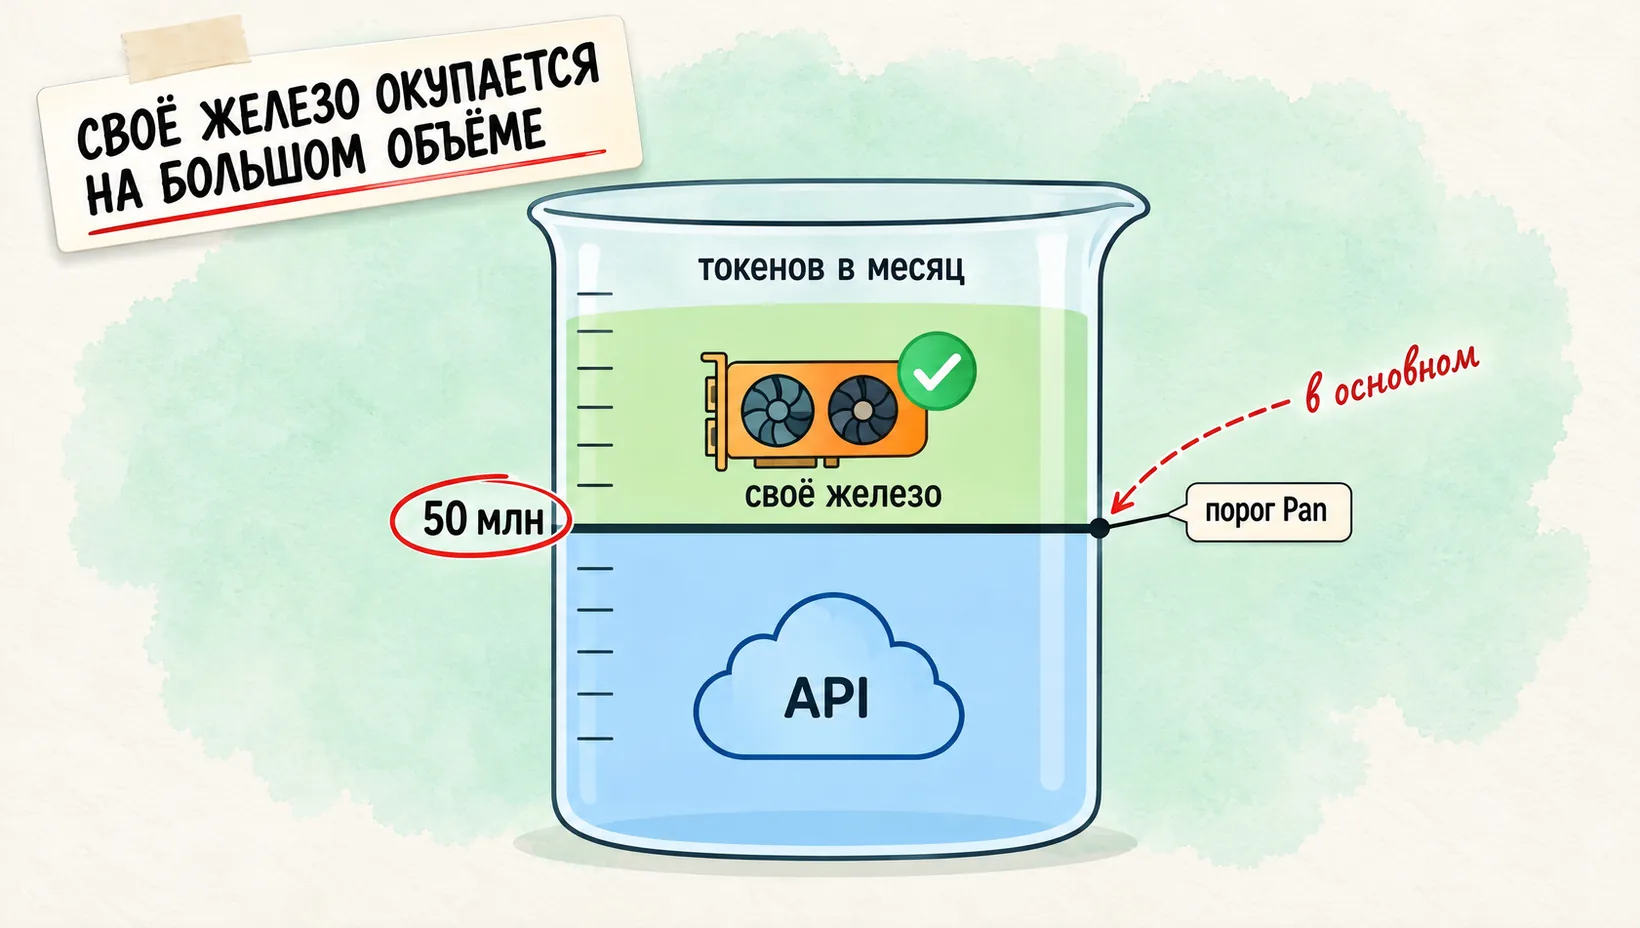
У небольших компаний с объёмом меньше 10 млн токенов в месяц малая модель на одной RTX 5090 (около $2 000) может окупиться за 0,3–3 месяца. Срок у Pan зависит от того, с какой платной моделью сравнивать, например с Claude-4 Opus или GPT-5. Зарплаты в расчёт не входят, хотя кто-то должен ставить драйверы и обновлять модели. Остальные строки сметы владельца собраны в статье сколько стоит ИИ-агент.
Второе условие у Pan касается данных, которые нельзя отдавать на чужой сервер. Где граница для файлов компании, мы разобрали в статье какие данные загружать в нейросеть.
Наш помощник на другом краю шкалы. На сентябрь 2026 года бесплатный тариф облачного провайдера пускал до пятидесяти вызовов в сутки, расход на модель был 0 ₽.
Свет карты дороже дешёвого API при 500 000 токенов в день
Даже купленная видеокарта может съесть на свет больше, чем стоит дешёвый API. Разработчик Flavio Copes обновил свой расчёт карты против API 3 августа 2026 года. С уже купленной картой своё у него выигрывает «почти при любом объёме».
Его же цифры говорят другое. При 500 000 токенов в день RTX 4090 берёт около 400 Вт, и при $0.16 за кВт·ч свет выходит $8.60 в месяц. Тот же объём через дешёвый API стоит $6, через средний $30.
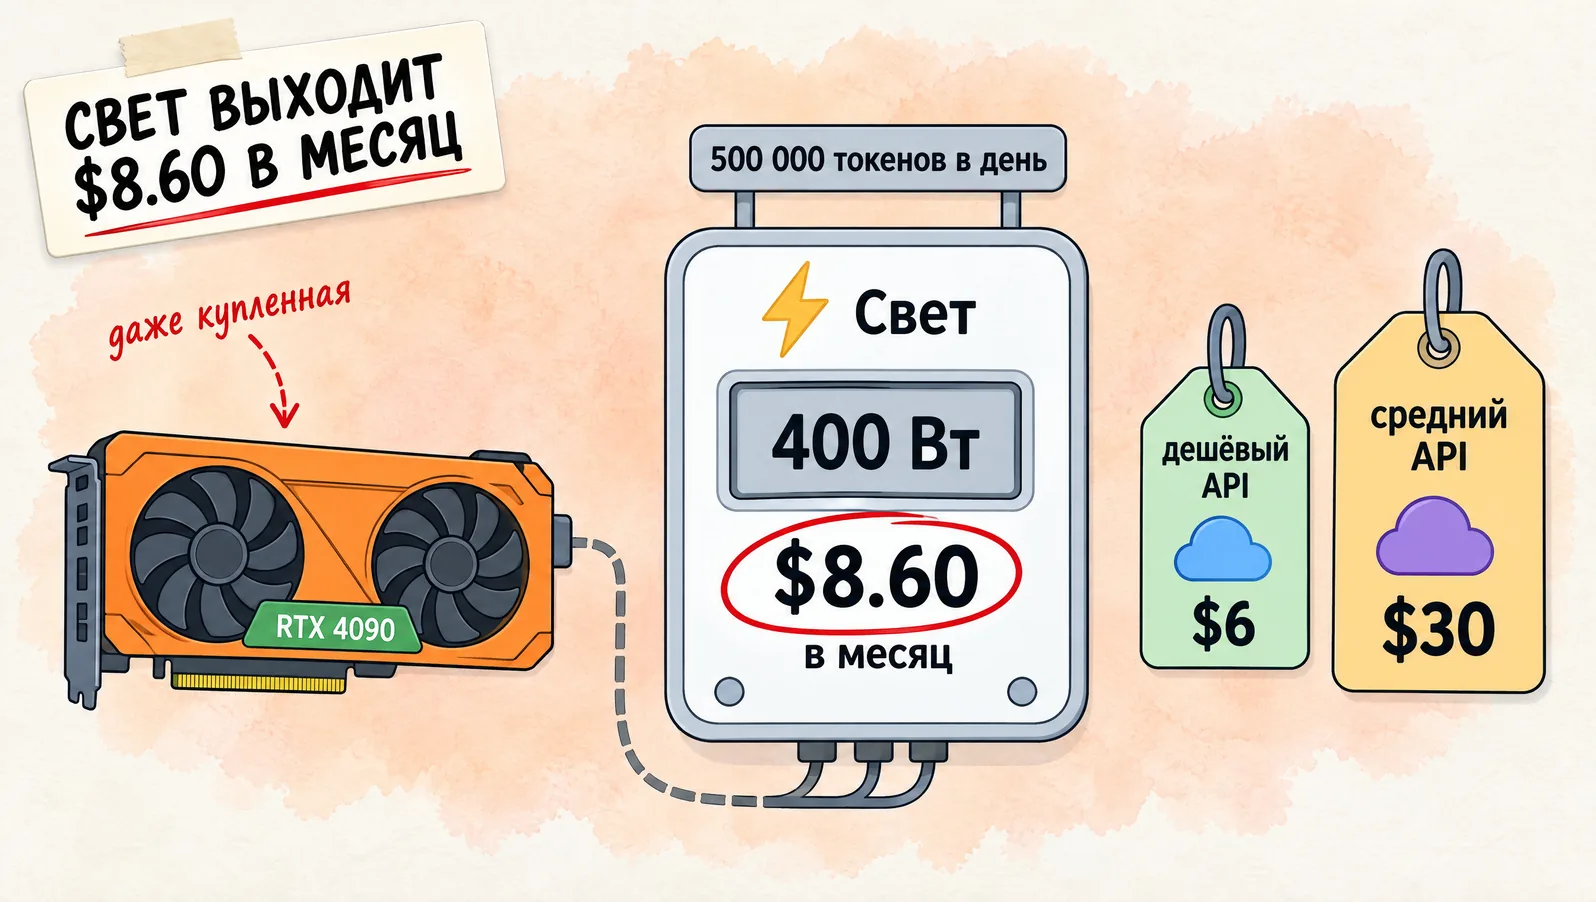
Покупку тоже приходится раскладывать по месяцам. Карта за $1 800 на три года службы стоит $50 в месяц до первого токена, а со светом около $59. Против дешёвого API при таком объёме карта не окупается никогда, против флагманского тарифа в $150 в месяц окупается примерно за 20 месяцев. Прайсы меняются, важен порядок чисел.
Поэтому нашему помощнику своя карта не нужна, бесплатное облако дешевле даже одного света.
Сначала посчитайте объём, потом выбирайте видеокарту
Решение о локальной нейросети начинается с числа токенов в день, видеокарту выбирают после.
- Калькулятор, до покупки. В калькуляторе Copes впишите в «Output tokens / day» токены ответов в день, в «$/M output tokens» цену API за миллион. Он покажет расход в месяц у своей карты и у API и срок окупаемости.
- Проверка компьютера, до покупки. Поставьте Ollama, программу для модели у себя, запустите модель и наберите `ollama ps`. В колонке Processor «100% GPU» значит, что модель в видеокарте. «100% CPU» говорит, что модель целиком легла в обычную память компьютера, а не в видеокарту.
- Облако выключить до первых данных. В файле `~/.ollama/server.json` поставьте `"disable_ollama_cloud": true` и перезапустите Ollama. В журнале появится строка «Ollama cloud disabled: true», так написано в справке Ollama, проверено 31 октября 2026 года.
Студенту хватит первого шага. Если вы всё же поставили Ollama и видите «100% CPU», берите API, иначе пробуйте модель у себя. Маркетологу шаг 1 покажет, где кончается выгода API, а владельцу с закрытыми данными нужны шаги 2 и 3.
Частые вопросы
Какая нейросеть работает без интернета?
Без интернета может работать, например, gpt-oss-20b. По словам OpenAI в августе 2025 года, ей хватает 16 ГБ памяти. В Ollama модель работает на вашем компьютере, но сначала программа скачивает её из интернета. Облачные модели самой Ollama обрабатываются на её серверах, их выключает настройка из третьего шага.
Как запустить нейронку на компьютере?
Поставьте Ollama и наберите в терминале `ollama run gemma4`, программа скачает модель и запустит её у вас.
Что такое локальная нейросеть?
Локальной называют нейросеть, которая работает на вашем компьютере. Запросы к ней Ollama, по её словам, не видит.